Paginación SEO: guía técnica para hacerlo bien hoy (2026)

Escrito por: Jesús Sánchez Diago
La paginación rara vez hunde una web por sí sola, pero puede dejar productos sin indexar, enterrar artículos a quince clics de la portada y gastar el rastreo de Google en URLs que nadie busca. Buena parte de lo que se publica sobre paginación SEO sigue recomendando rel="next" y rel="prev", una señal que Google confirmó en 2019 que ya no utilizaba para indexar.
Esta guía explica qué hacer hoy: cómo implementar la paginación paso a paso, qué ocurre en WordPress y WooCommerce, en qué se diferencia de los filtros facetados de una tienda online y cómo comprobar en Search Console si tu paginación está causando problemas.
¿Qué es la paginación SEO?
Paginar es dividir un listado largo en varias URLs consecutivas: la página 1 muestra los primeros elementos, la página 2 los siguientes, y así hasta el final. La paginación SEO es el conjunto de decisiones técnicas que permiten a los buscadores rastrear esa serie, entender cómo se relacionan sus páginas e indexar lo que contienen.
Aparece en más sitios de los que parece:
- El archivo del blog y sus categorías o etiquetas.
- Los listados de producto de una tienda online.
- Los resultados del buscador interno.
- Los hilos de comentarios o de foro.
- Los artículos largos divididos en varias páginas.
En todos los casos el problema de fondo es el mismo: el contenido que vive en la página 7 solo es accesible si el buscador llega hasta la página 7.
¿Cómo afecta la paginación al SEO?
Cada página de la serie es una URL más que Google tiene que descubrir, rastrear y decidir si indexa. De ahí salen cuatro efectos que conviene separar, porque no pesan igual en todas las webs.
Rastreo. Google asigna a cada sitio una capacidad de rastreo limitada. Su propia documentación sobre presupuesto de rastreo indica que el asunto preocupa sobre todo en sitios grandes (más de un millón de URLs únicas) o medianos con contenido que cambia a diario (más de 10.000 URLs). En un blog de 200 entradas, la paginación no agota nada. En un catálogo con miles de referencias, sí compite por ese rastreo con las fichas de producto.
Profundidad. Si una categoría solo enlaza a la página siguiente, un producto de la página 12 queda a doce clics de la entrada a la categoría. Cuanto más profunda está una URL, con menos frecuencia la rastrea Google y menos autoridad interna le llega.
Indexación de las páginas 2 en adelante. Las páginas intermedias suelen compartir título, meta description y texto introductorio con la primera. Google puede indexarlas, ignorarlas o elegir otra URL como canónica. Lo que importa es que sigan rastreándose, porque son el camino hacia los elementos que enlazan.
Reparto del enlazado interno. La autoridad que recibe una categoría se reparte entre sus enlaces. Cuantas más páginas tiene la serie y peor se enlazan entre sí, menos llega a los productos o artículos del final. Una configuración errónea del canonical, por ejemplo apuntando todas las páginas a la primera, agrava el problema porque le dice a Google que las páginas intermedias sobran.
rel="next" / "prev": qué pasó y qué se hace hoy
Durante años, la recomendación estándar fue marcar la serie con <link rel="next"> y <link rel="prev"> en el <head> de cada página, para indicar a Google que formaban una secuencia.
En marzo de 2019, el equipo de Google Search confirmó públicamente que llevaba tiempo sin usar esas etiquetas para indexar. Google trata cada página paginada como una URL independiente y deduce la relación entre ellas a partir de los enlaces que encuentra en el contenido.
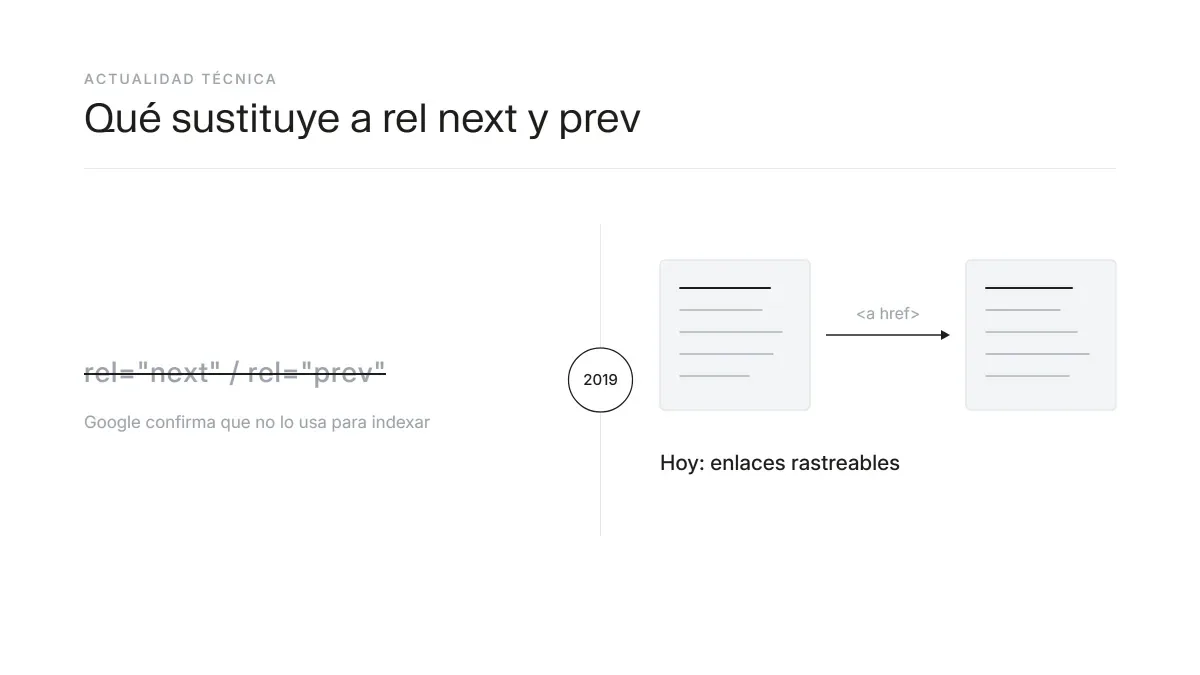
¿Hay que quitarlas? No hace falta. No perjudican, pueden servir a otros buscadores (Bing ha indicado que las usa como pista para descubrir URLs y entender la estructura) y algunos plugins las siguen generando. Lo que no tiene sentido es confiar en ellas para resolver la paginación.
Lo que sustituye a esas etiquetas son tres prácticas que la documentación de Google para comercio electrónico recoge de forma explícita:
- Dar a cada página su propia URL.
- Enlazar las páginas entre sí con enlaces HTML normales.
- No canonicalizar las páginas intermedias a la primera.
Cómo implementar la paginación SEO paso a paso
Si partes de cero o vas a rehacer un listado, este es el orden de trabajo. Cada paso corrige un error que aparece a menudo en auditorías de tiendas y blogs.
URLs rastreables (no scroll infinito ni "cargar más" sin enlaces)
Cada página de la serie necesita una URL propia y estable, por ejemplo /categoria/zapatillas/page/2/ o /categoria/zapatillas?page=2. Ambos formatos funcionan; lo importante es elegir uno y mantenerlo.
Estos cuatro fallos rompen el rastreo:
- Fragmentos en la URL. Google ignora lo que va detrás de
#, así que/zapatillas#page=2es para él la misma URL que la página 1. - Botones sin enlace. Un botón "Cargar más" que pide los productos por JavaScript sin un
<a href>detrás no lleva a ninguna parte: Googlebot no hace clic en botones. - Scroll infinito sin páginas detrás. Si los elementos solo aparecen al desplazarse, Google no los ve. La solución habitual es mantener URLs paginadas equivalentes, enlazarlas en el HTML y actualizar la URL del navegador a medida que el usuario avanza.
- Duplicar la primera página. Si
/zapatillas/y/zapatillas?page=1muestran lo mismo, la segunda debería redirigir a la primera o no enlazarse nunca.
Un último detalle: las URLs más allá del final de la serie (/page/999/) deben devolver un 404. Si devuelven un 200 con un listado vacío, generan páginas que Google puede rastrear sin fin.
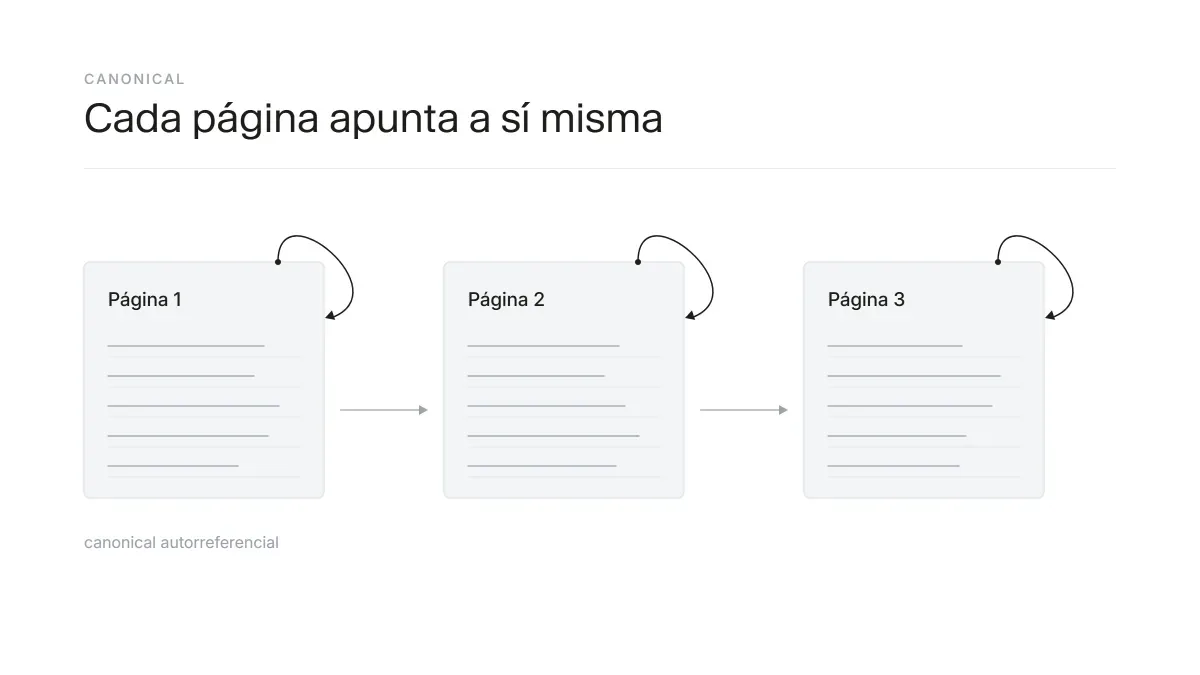
Canonical autorreferencial por página (el error de canonicalizar a la página 1)
Cada página debe declararse canónica a sí misma. La página 2 de una categoría lleva en su <head>:
<link rel="canonical" href="https://ejemplo.com/categoria/zapatillas/page/2/">
El error clásico es apuntar el canonical de todas las páginas a la primera. La intención suele ser evitar contenido duplicado, pero las páginas 2 y siguientes muestran productos distintos. Al canonicalizarlas a la página 1 le pides a Google que las descarte, y con ellas se debilita el único camino interno hacia esos productos. Google puede ignorar un canonical que no encaja con el contenido, pero no conviene dejarle esa decisión.
Mientras tanto, cuida lo básico de SEO on page en la serie: la página 1 concentra el título y el texto optimizado de la categoría, y las siguientes pueden añadir "Página 2" al título para diferenciarse. El texto descriptivo largo de la categoría basta con mostrarlo en la primera.
Enlazado interno y la opción "ver todo" (view-all): cuándo sí, cuándo no
La navegación de la serie decide cuántos clics hay hasta el final. Un paginador que solo muestra "Anterior" y "Siguiente" obliga a recorrer la lista página a página. Uno que enlaza a la primera, la última y varias páginas intermedias (1, 2, 3 … 10, 20, 34) acorta esa distancia para usuarios y rastreadores.
La paginación es solo una parte del enlazado. Las fichas más importantes deberían recibir enlaces desde más sitios: subcategorías, bloques de destacados, artículos del blog. Cómo repartir esos enlaces en toda la web lo explicamos en nuestra guía de arquitectura web SEO.
La página "ver todo" reúne el listado completo en una sola URL. Tiene sentido cuando la lista es manejable y la página carga rápido: en ese caso puedes canonicalizar las páginas paginadas a la versión completa. En una categoría con cientos de productos, una página con todo pesa demasiado y empeora la experiencia en móvil, así que ahí es mejor mantener la paginación con canonical propio.
Paginación en WordPress y WooCommerce
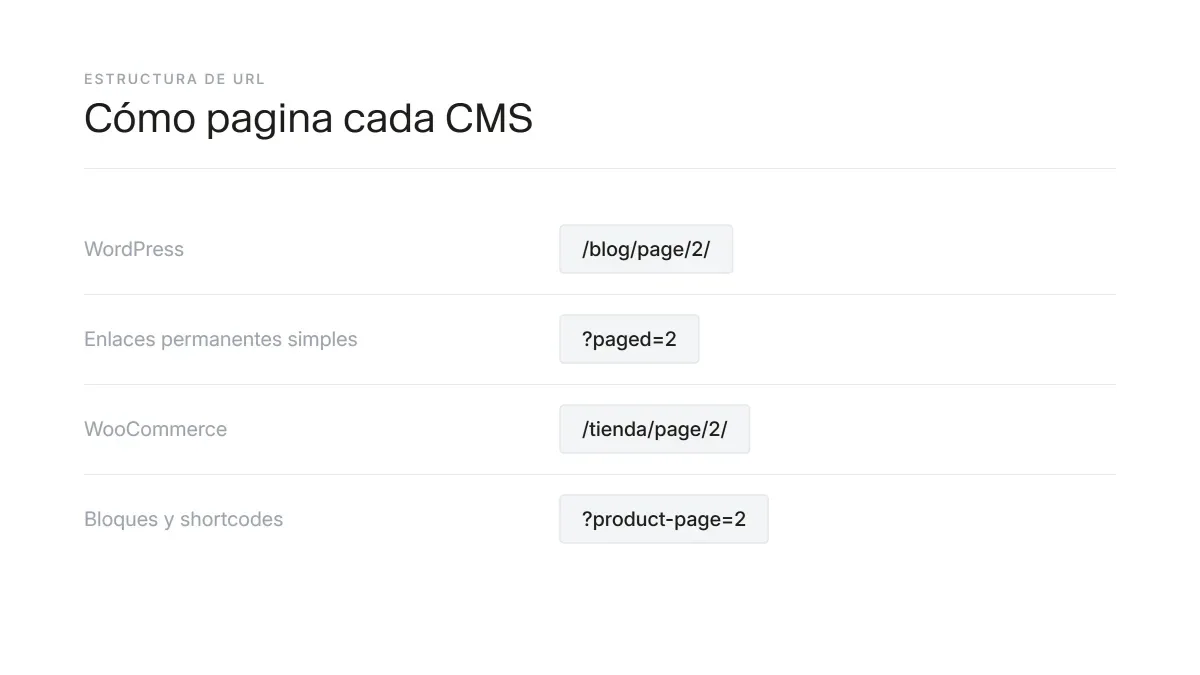
WordPress pagina de forma automática los archivos del blog, las categorías, las etiquetas y los resultados de búsqueda. Con los enlaces permanentes configurados, las URLs siguen el patrón /blog/page/2/. Con los enlaces permanentes simples, aparece el parámetro ?paged=2. Si divides una entrada con el bloque de salto de página, cada parte vive en /nombre-de-la-entrada/2/.
WooCommerce hereda ese comportamiento: la tienda y las categorías de producto se paginan como /tienda/page/2/ o /categoria-producto/zapatillas/page/2/. Algunos bloques y shortcodes de listados usan su propio parámetro, como ?product-page=2, lo que puede generar URLs paralelas para el mismo contenido.
Los plugins de SEO resuelven la mayor parte por defecto. Yoast deja las páginas 2 en adelante indexables y con canonical autorreferencial. Rank Math tiene un ajuste para marcar como noindex las páginas paginadas; revisa si está activado en tu instalación, porque alguien pudo activarlo para "evitar duplicados".
Ese noindex es el problema más frecuente en WordPress. Google ha explicado que una página con noindex durante mucho tiempo acaba tratándose también como si sus enlaces no se siguieran. Si un producto solo está enlazado desde la página 5 de su categoría y esa página lleva meses en noindex, el producto pierde su vía de descubrimiento.
La otra fuente habitual de errores es el tema. Muchos temas comerciales sustituyen el paginador por un botón "Cargar más" en AJAX que no deja enlaces en el HTML. Si es tu caso, la corrección está en la plantilla y conviene hacerla con alguien de desarrollo web, para que el botón siga funcionando para el usuario y el paginador quede disponible para los buscadores. Si tu tienda tiene otros frentes abiertos, en la guía de SEO para WooCommerce repasamos el resto de la configuración.
Paginación vs filtros facetados en e-commerce
En una tienda online, la paginación suele cargar con la culpa de problemas de rastreo que provocan los filtros. La diferencia está en cómo crecen las URLs.
Una categoría de 400 productos con 24 por página genera 17 páginas. Es una serie finita que crece en proporción al catálogo. Los filtros facetados (color, talla, marca, precio, orden) se combinan entre sí. Con 5 colores, 6 tallas, 8 marcas y 4 formas de ordenar, una sola categoría admite 960 combinaciones de filtros, y cada una puede tener a su vez su propia paginación.
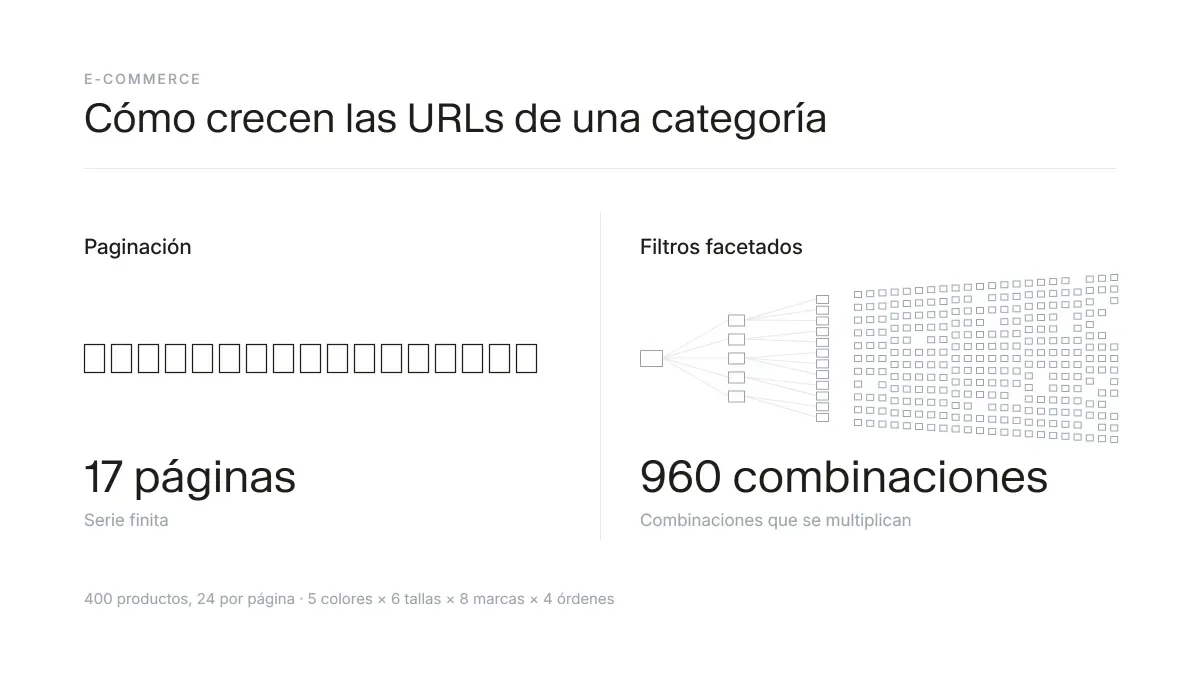
| Paginación | Filtros facetados | |
|---|---|---|
| Qué genera | Una serie finita de páginas | Combinaciones que se multiplican |
| Crecimiento | Proporcional al número de productos | Multiplicativo según filtros y valores |
| ¿Indexar? | Sí, con canonical propio | Solo los filtros con búsquedas |
| Tratamiento habitual | Enlaces rastreables entre páginas | URL estática para los filtros útiles y bloqueo del resto |
Por eso el tratamiento es distinto. Algunas combinaciones tienen búsquedas propias, como "zapatillas trail mujer", y merecen una URL limpia, indexable y enlazada, casi como una subcategoría. El resto conviene sacarlo del rastreo. La documentación de Google sobre navegación facetada propone bloquear en robots.txt los parámetros de filtros que no quieres rastreados y devolver un 404 cuando una combinación no tiene resultados.
Ojo con confiar solo en el canonical o en el noindex para los filtros: ambos necesitan que Google rastree la URL para leerlos, así que no ahorran rastreo. Sirven para consolidar señales, pero el volumen de URLs rastreadas sigue ahí.
Errores comunes y cómo diagnosticarlos
Estos son los fallos que más se repiten al revisar la paginación de una web:
- Canonical de todas las páginas apuntando a la página 1.
noindexen las páginas 2 en adelante.- Botón "Cargar más" o scroll infinito sin enlaces
<a href>. - Paginación con fragmentos
#en lugar de URLs. - La página 1 accesible en dos URLs (
/categoria/y/categoria/page/1/). - Páginas fuera de rango que devuelven 200 en vez de 404.
- Parámetros de filtros y orden rastreables e indexables sin control.
- URLs paginadas bloqueadas en
robots.txt, que cortan el acceso a los productos.
Para detectarlos, sigue este orden:
- Informe de indexación de páginas de Search Console. Revisa los motivos de exclusión y abre los ejemplos. Si aparecen muchas URLs con
/page/o?page=en "Excluida por la etiqueta noindex" o en "Duplicada: Google ha elegido una versión canónica diferente a la del usuario", tienes una pista directa. - Inspección de URLs. Analiza una página 3 o 4 de una categoría importante. Compara el canonical que declaras con el que ha elegido Google y comprueba si la URL está indexada y cuándo se rastreó por última vez.
- Estadísticas de rastreo. En Ajustes de Search Console, mira qué tipo de URLs rastrea Googlebot y si hay picos de rastreo sin relación con publicaciones nuevas.
- Logs del servidor. Filtra las peticiones de Googlebot y agrúpalas por patrón de URL: fichas de producto, páginas paginadas, URLs con parámetros de filtro. Si los parámetros se llevan más peticiones que las fichas, el problema está en los filtros.
- Rastreo propio. Pasa una herramienta como Screaming Frog con la renderización de JavaScript desactivada y mira la profundidad de clic de los productos. Si hay fichas a más de diez clics o que no aparecen, la paginación o el tema no están dejando enlaces en el HTML.
Un síntoma que suele pasar desapercibido: productos nuevos que tardan semanas en indexarse mientras las fichas antiguas, enlazadas desde la página 1, se indexan en días. Casi siempre apunta a profundidad excesiva.
Preguntas frecuentes
¿Cómo hacer una paginación?
Divide el listado en páginas con URL propia (/page/2/ o ?page=2), enlázalas entre sí con enlaces HTML <a href>, pon en cada una un canonical que apunte a sí misma y deja la primera página en la URL base de la categoría. Si usas un botón "Cargar más" o scroll infinito, mantén las URLs paginadas enlazadas por detrás.
¿Hay que poner noindex en las páginas 2 en adelante?
En general, no. Un noindex prolongado puede hacer que Google deje de seguir los enlaces de esas páginas, y son justo las que enlazan a los productos o artículos más antiguos. Si no quieres que aparezcan en resultados, diferenciarlas en el título suele bastar.
¿Es mejor el scroll infinito que la paginación para SEO?
De cara a Google, el scroll infinito solo funciona si detrás hay URLs paginadas rastreables. La elección para el usuario depende del listado: en un catálogo donde se comparan productos y se vuelve atrás a menudo, la paginación permite regresar a la misma posición, mientras que un feed de lectura continua se recorre más cómodo con scroll. Las dos opciones se pueden combinar en la misma plantilla.
¿Cuántos elementos conviene mostrar por página?
No hay una cifra que Google recomiende. Cuantos más elementos por página, menos páginas y menos profundidad, pero más peso y peor tiempo de carga. Ajústalo según el tamaño de las imágenes y el rendimiento de la plantilla en móvil.
La paginación es de las partes del SEO técnico que se configuran una vez y se olvidan, hasta que un cambio de tema o de plugin la rompe sin que nadie lo note. Si gestionas un catálogo grande o sospechas que Google no está llegando a todos tus productos, en nuestro servicio de posicionamiento SEO revisamos rastreo, indexación y enlazado con datos de Search Console y de los logs de tu servidor.
Artículos relacionados
Sigue aprendiendo
Cómo aparecer en AI Overviews y en el modo IA de Google
Para aparecer en AI Overviews tu página tiene que estar indexada y poder mostrarse con fragmento; después, Google cita a...
Cómo posicionarse en Gemini y aparecer en sus respuestas
Posicionarse en Gemini es conseguir que la IA de Google cite tu web o recomiende tu marca. Cómo elige sus fuentes, el aj...
Migración SEO: cómo cambiar de web sin perder posicionamiento
Cómo migrar una web (de dominio, de CMS, a HTTPS o con URLs nuevas) sin perder posicionamiento: el checklist antes, dura...