Canibalización SEO: cómo detectarla y solucionarla (2026)

Escrito por:Jesús Sánchez Diago
La canibalización SEO suele aparecer en webs que llevan años publicando sin un mapa de keywords: dos artículos que tratan lo mismo con títulos distintos, una categoría que compite con su propio producto estrella, una etiqueta de WordPress que repite el nombre de una categoría o una landing antigua que nadie redirigió. El síntoma se ve antes en Search Console que en ningún otro sitio: dos URLs que se turnan la misma consulta sin que ninguna pase de la segunda página.
Esta guía se centra en las dos partes que casi siempre se quedan cortas: cómo detectar la canibalización con datos de Search Console y cómo decidir, caso por caso, si toca fusionar, redirigir, canonicalizar, reescribir o desindexar.
¿Qué es la canibalización SEO?
Hay canibalización cuando dos o más URLs del mismo dominio compiten por la misma búsqueda y responden a la misma intención. Google tiene que elegir cuál mostrar y, como ninguna se impone a la otra, va alternando entre ellas o deja a las dos en posiciones discretas.
El matiz que más se confunde está en la palabra «intención». Que dos páginas compartan una keyword no basta para hablar de canibalización. Una guía sobre cómo elegir zapatillas de trail y la categoría de la tienda que las vende usan las mismas palabras, pero atienden a búsquedas distintas (aprender a elegir frente a comprar). El problema empieza cuando las dos páginas sirven para lo mismo y el buscador no tiene ninguna señal que le diga cuál preferir.
Por qué la canibalización te perjudica
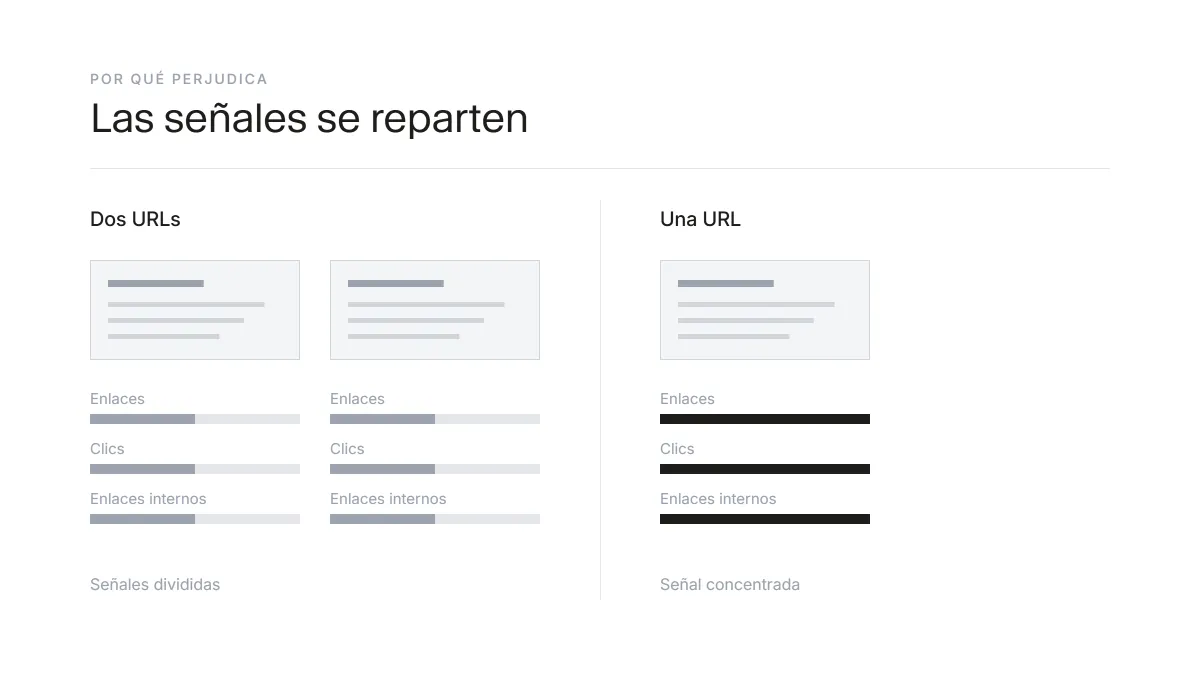
Las señales se reparten. Los enlaces externos, los enlaces internos y el historial de clics de una búsqueda se dividen entre dos URLs. Una sola página que reuniera todo eso tendría más opciones de subir que cualquiera de las dos por separado.
Las posiciones se vuelven inestables. Cuando Google no sabe qué URL mostrar, prueba una durante un tiempo y después la otra, y una página que entra y sale de los resultados difícilmente consolida un puesto en la parte alta.
Google puede elegir la página equivocada. Es habitual que un artículo antiguo del blog le gane la consulta a la página de servicio. La visita llega a un contenido sin formulario ni precio y se queda en lectura.
El rastreo y el enlazado interno se dispersan. En webs grandes, cada URL redundante consume rastreo que podría ir a páginas nuevas o actualizadas. Y el enlazado interno pierde dirección: unos artículos enlazan a una versión, otros a la otra, y ninguna recibe todo el apoyo.
Ver varias URLs para una consulta no siempre es un problema. Si Google muestra dos páginas tuyas a la vez en la primera página, no hay nada que arreglar. La pregunta útil es si la página que quieres posicionar está donde debería o hay otra URL tuya estorbándole.
Causas más frecuentes
Contenido duplicado o casi duplicado por keyword
Es una causa muy frecuente en blogs con varios años de vida. Se publica «cómo elegir un CRM» y, dos años después, alguien del equipo escribe «guía para elegir CRM» sin revisar lo que ya existía. Las dos piezas responden a lo mismo y se reparten la búsqueda.
Nos lo encontramos al preparar nuestro propio blog. Al evaluar la keyword «técnicas SEO» comprobamos que su intención coincidía con la de un artículo de estrategias SEO ya publicado: en ambos casos el usuario busca una lista de tácticas que funcionan. Crear una página nueva habría enfrentado a dos URLs propias, así que la keyword se trabaja dentro del artículo existente.
Mala arquitectura y falta de mapa de keywords
Cuando la estructura de la web crece sin plan, aparecen páginas de servicio que se solapan: /servicios/seo/ y /posicionamiento-web/ explicando lo mismo con otras palabras, o una categoría y una subcategoría que atacan la misma búsqueda. Una buena arquitectura web SEO asigna cada tema a un único nivel de la jerarquía, y eso elimina buena parte de estos choques antes de que existan.
Etiquetas y paginación mal gestionadas (tags, /page/2/, filtros)
WordPress crea un archivo indexable por cada etiqueta y cada categoría. Si la etiqueta «seo» y la categoría «SEO» agrupan los mismos artículos, son dos listados casi idénticos compitiendo por la misma búsqueda. Lo mismo ocurre con las páginas siguientes de un listado cuando comparten título e introducción con la primera, un caso que detallamos en la guía de paginación SEO.
En tiendas online, los filtros facetados multiplican el problema: cada combinación de color y talla puede generar una URL indexable que compite con la categoría principal.
Migraciones y URLs viejas sin redirigir
Tras un rediseño o un cambio de estructura, la URL antigua sigue respondiendo con código 200 junto a la nueva. También pasa con las versiones con y sin www o con parámetros de campaña que Google acaba indexando.
Cómo detectar la canibalización SEO paso a paso
A ojo se falla mucho, porque el parecido entre títulos dice poco sobre qué consultas comparten dos páginas. Lo que manda es qué URLs muestra Google para cada búsqueda, y ese dato está en Search Console. Cuando hacemos una auditoría SEO, este cruce entre consultas y páginas es de los primeros que revisamos.
Search Console: informe de Rendimiento por consulta (dos URLs para la misma query)
- Abre Rendimiento > Resultados de búsqueda y elige un periodo amplio, de 3 a 6 meses, para que las rotaciones tengan tiempo de aparecer.
- En la pestaña Consultas, haz clic en la búsqueda que quieres revisar. Search Console añade un filtro con esa consulta exacta.
- Cambia a la pestaña Páginas. Verás todas las URLs de tu web que han obtenido impresiones para esa consulta.
- Activa las métricas de CTR y Posición media para comparar cómo rinde cada URL.
Si aparecen dos o más URLs con impresiones relevantes y posiciones parecidas, tienes una candidata. Si una acumula casi todas las impresiones y la otra solo registra unas pocas, lo normal es que no haya conflicto.
Para una web entera, la interfaz se queda corta (sus tablas muestran como mucho 1.000 filas): exporta consulta y página con la API de Search Console o con Looker Studio y quédate con las consultas que tienen más de una URL con impresiones.
El síntoma clave: posiciones que rotan entre URLs en el tiempo
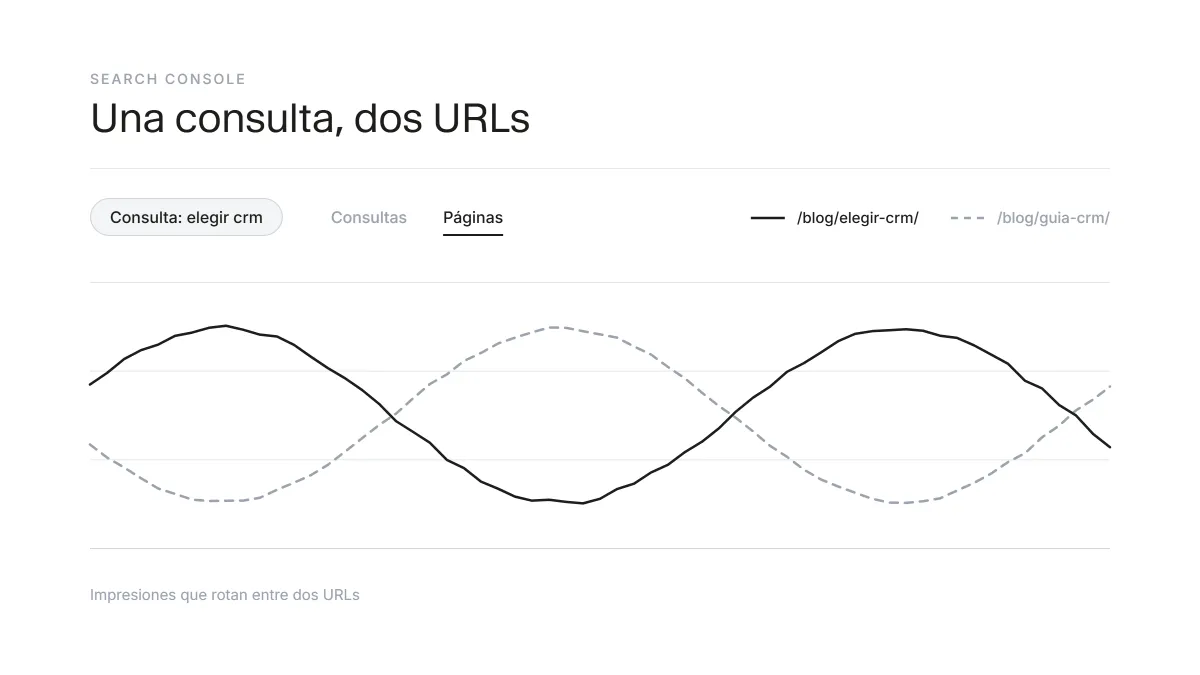
Con el filtro de consulta puesto, añade un segundo filtro de página con la primera URL y observa la gráfica de impresiones y posición. Después cambia el filtro a la segunda URL. Cuando las impresiones de una caen justo en las semanas en que suben las de la otra, Google está alternando entre ambas porque no tiene una preferida. Esa curva en espejo es la señal más fiable de canibalización.
site: y búsqueda por operador para ver qué indexa Google
La búsqueda site:tudominio.com zapatillas trail devuelve las páginas de tu dominio que Google tiene indexadas y relaciona con esos términos. Añadir intitle: acota a las que llevan la palabra en el título. Sirve para descubrir URLs que aún no salen en Search Console; confírmalas después con los datos de Rendimiento, porque los resultados de site: son aproximados.
Cruce con tu mapa de keywords
Si tienes un mapa que asigna cada keyword a una URL, compara esa asignación con lo que muestra Search Console. Cada discrepancia tiene dos lecturas posibles: hay una página compitiendo con la asignada, o el mapa se ha quedado desactualizado. Si no tienes mapa, la exportación del paso anterior sirve para empezarlo.
Cómo solucionar la canibalización SEO (árbol de decisión)
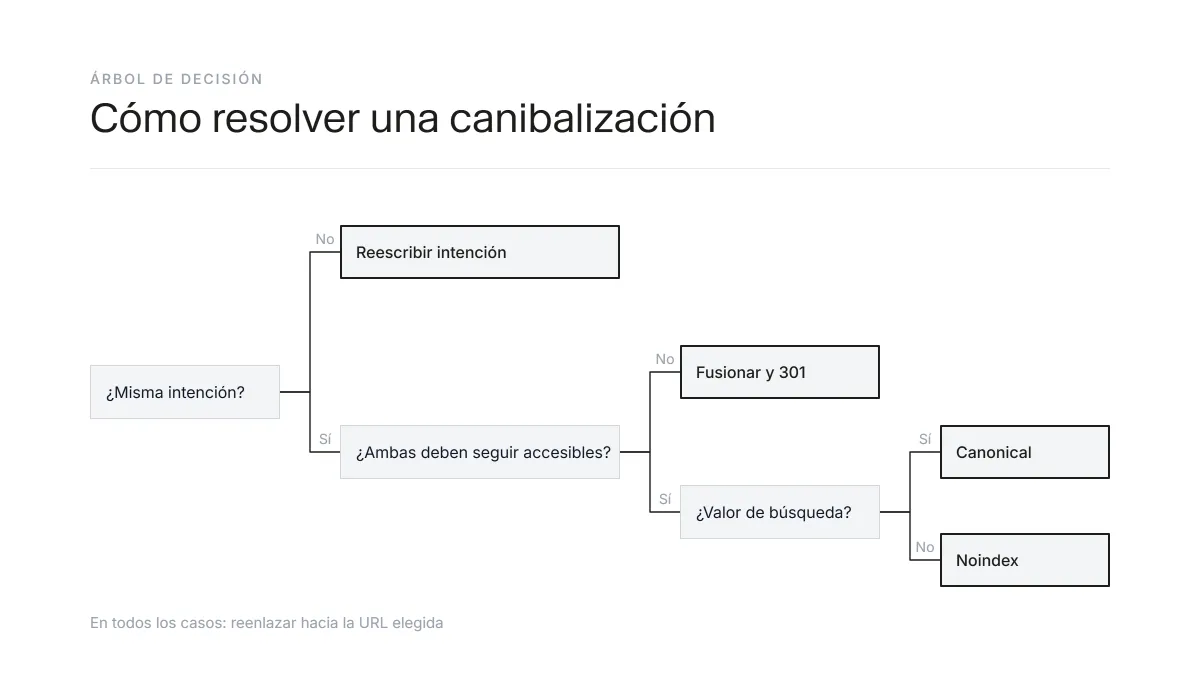
No hay una solución única. Antes de tocar nada, responde a estas cuatro preguntas sobre las URLs en conflicto:
- ¿Responden a la misma intención o a intenciones distintas?
- ¿Las dos tienen que seguir existiendo para el usuario?
- ¿Alguna tiene enlaces externos, tráfico o conversiones que merezca conservar?
- ¿Cuál es la URL que quieres que posicione?
Con esas respuestas, la decisión se ordena así:
| Situación | Solución |
|---|---|
| Misma intención y la página débil sobra | Fusionar el contenido y redirigir con 301 |
| Misma intención, pero ambas deben seguir accesibles | Canonical de la débil a la fuerte |
| Intenciones distintas que se han mezclado | Reescribir para separar la intención |
| Página útil para navegar, sin valor de búsqueda | Noindex |
| Cualquiera de los casos anteriores | Reenlazar internamente hacia la URL elegida |
Fusionar las páginas en una sola y redirigir 301
Cuándo aplica: las dos URLs responden a lo mismo y el usuario no pierde nada si desaparece una. Suele ser la opción adecuada en blogs con artículos solapados.
Elige como destino la URL más fuerte (la que tenga más enlaces externos y mejor historial en Search Console). Lleva a ella lo que aporte la otra página, como ejemplos o datos que no estén repetidos, y redirige la URL eliminada con un 301. Google ha declarado públicamente que las redirecciones 301 no hacen perder PageRank, así que los enlaces que apuntaban a la página antigua siguen sumando. Después, actualiza los enlaces internos para que apunten al destino.
Canonical de la débil a la fuerte cuando ambas deben vivir
Cuándo aplica: las páginas tienen un contenido muy parecido, pero las dos deben seguir accesibles: variantes de un producto por color o una landing de campaña que replica una página de servicio.
Añade en la página secundaria una etiqueta rel="canonical" que apunte a la principal. Google trata el canonical como una sugerencia: puede ignorarlo si las dos páginas difieren mucho o si los enlaces internos y el sitemap apuntan a la otra URL. Para que lo respete, todas las señales deben ir en la misma dirección.
Reescribir para separar la intención (informacional vs transaccional)
Cuándo aplica: las dos páginas tienen razón de ser, pero una ha invadido el terreno de la otra. El caso típico es un artículo informativo que le quita la consulta comercial a la página de servicio.
Reescribe la página informativa para que responda a preguntas de aprendizaje (qué es y cómo se hace) y retira los términos comerciales de su title y su H1. La página de servicio conserva la consulta comercial, y el artículo la enlaza con un anchor descriptivo. Si quieres repasar qué elementos de la página envían esas señales, lo explicamos en la guía de SEO on page y off page.
Desindexar (noindex) lo que no aporta
Cuándo aplica: la página sirve para navegar pero no tiene valor en los resultados de búsqueda. Archivos de etiquetas, resultados del buscador interno, combinaciones de filtros o listados duplicados entran en este grupo.
Añade la meta etiqueta noindex y deja la página rastreable. Si la bloqueas en robots.txt, Google no puede leer la etiqueta y la URL puede seguir en el índice. Cuando la página no sirve ni para navegar, lo más limpio es eliminarla y redirigirla a la URL más cercana o devolver un 410.
Reenlazar internamente hacia la URL elegida
Cuándo aplica: siempre, como complemento de cualquiera de las soluciones anteriores. En canibalizaciones leves, cuando una URL ya domina y la otra solo asoma de vez en cuando, puede bastar por sí solo.
Revisa los menús, las migas de pan, los enlaces dentro del texto y los bloques de artículos relacionados. Todos los enlaces internos cuyo anchor contenga la keyword en disputa deben apuntar a la URL elegida.
Cómo prevenir la canibalización desde el principio
Una intención, una URL. La prevención empieza en el mapa de keywords: cuando haces un keyword research, agrupa las keywords por intención y asigna cada grupo a una sola página.
Una arquitectura sin solapes. Define qué tema vive en cada categoría; si una etiqueta agrupa los mismos contenidos que una categoría, sobra una de las dos.
Una comprobación antes de publicar. Antes de encargar o escribir un contenido, busca la keyword en el mapa y lanza un site: en Google. Si ya existe una página que responde a esa intención, lo que toca es actualizarla y ampliarla.
Una revisión periódica. Repite el cruce de consultas y páginas en Search Console cada pocos meses y siempre después de una migración o un rediseño.
Preguntas frecuentes
¿La canibalización siempre es mala?
No. Si dos URLs tuyas aparecen a la vez en la primera página para una búsqueda, ocupas más espacio en los resultados y no hay nada que corregir. Solo hay que actuar cuando la competencia entre ellas impide que la página que te interesa suba o se mantenga.
¿Cómo detecto la canibalización sin herramientas de pago?
Con Search Console y el operador site: tienes suficiente. El informe de Rendimiento, filtrado por consulta, muestra qué URLs obtienen impresiones para cada búsqueda y cómo evoluciona su posición. Las herramientas de pago ahorran tiempo en webs grandes, aunque sus posiciones y volúmenes son estimaciones.
¿Qué es mejor, fusionar o usar canonical?
Fusionar y redirigir con 301 cuando una página puede desaparecer sin perjudicar al usuario, porque es la señal más fuerte. El canonical queda para cuando las dos tienen que seguir accesibles.
¿Cuánto tarda en recuperarse una canibalización?
Depende de lo rápido que Google vuelva a rastrear las URLs afectadas. En webs con rastreo frecuente los cambios pueden verse en días; en webs pequeñas o con poca actividad, puede llevar semanas. Puedes acelerarlo solicitando la indexación de la URL elegida desde la inspección de URLs de Search Console.
Si tu web tiene años de contenido acumulado y sospechas que varias páginas se están pisando, cruzar consultas y páginas y reordenar el enlazado interno es el tipo de trabajo que hace un consultor SEO con acceso a tus datos de Search Console.
Artículos relacionados
Sigue aprendiendo
Mi negocio no aparece en Google Maps: causas y cómo solucionarlo
Por qué tu negocio no aparece en Google Maps: las seis causas habituales, cómo comprobar el estado de tu ficha, el alta ...
Cómo hacer un keyword research paso a paso
Un keyword research bien hecho responde a una pregunta de negocio: qué búsquedas hace la gente que puede acabar compránd...
Cómo conseguir backlinks: guía de tácticas que funcionan (2026)
Guía práctica para conseguir backlinks de calidad en 2026: tácticas que funcionan, qué evitar para no penalizar y cómo m...